

当客户在网站、App或微信上发出一句咨询,AI客服是如何在秒级内理解问题、检索答案并给出回复的?这背后是一条由自然语言处理(NLP)、意图识别、知识库检索和大语言模型(LLM)共同构成的技术链路。本文将系统拆解AI客服工作原理,从用户输入到自动回复,讲清楚每一个环节的作用、关键技术与企业落地要点。
据中国信通院发布的《人工智能产业发展研究报告(2025年)》,新一代人工智能技术在意图理解、多模态交互、内容生成等能力方面表现突出,正在加速向高附加值领域渗透,智能客服是其中的典型应用场景之一[1]。同时,Gartner在2024年发布的报告中预测,到2026年将有50%的客服和支持组织部署生成式AI驱动的虚拟助手[2]。理解AI客服的技术原理,是企业评估选型、规划落地的前提。
一、AI客服工作原理:八步完整技术链路
一条完整的AI客服处理链路,通常包含”多渠道接入与预处理—意图识别—对话状态管理—知识库检索—答案生成—回复输出—人工接管—质检优化”八个环节。下图展示了从客户提问到获得回复、再到持续优化的全过程:
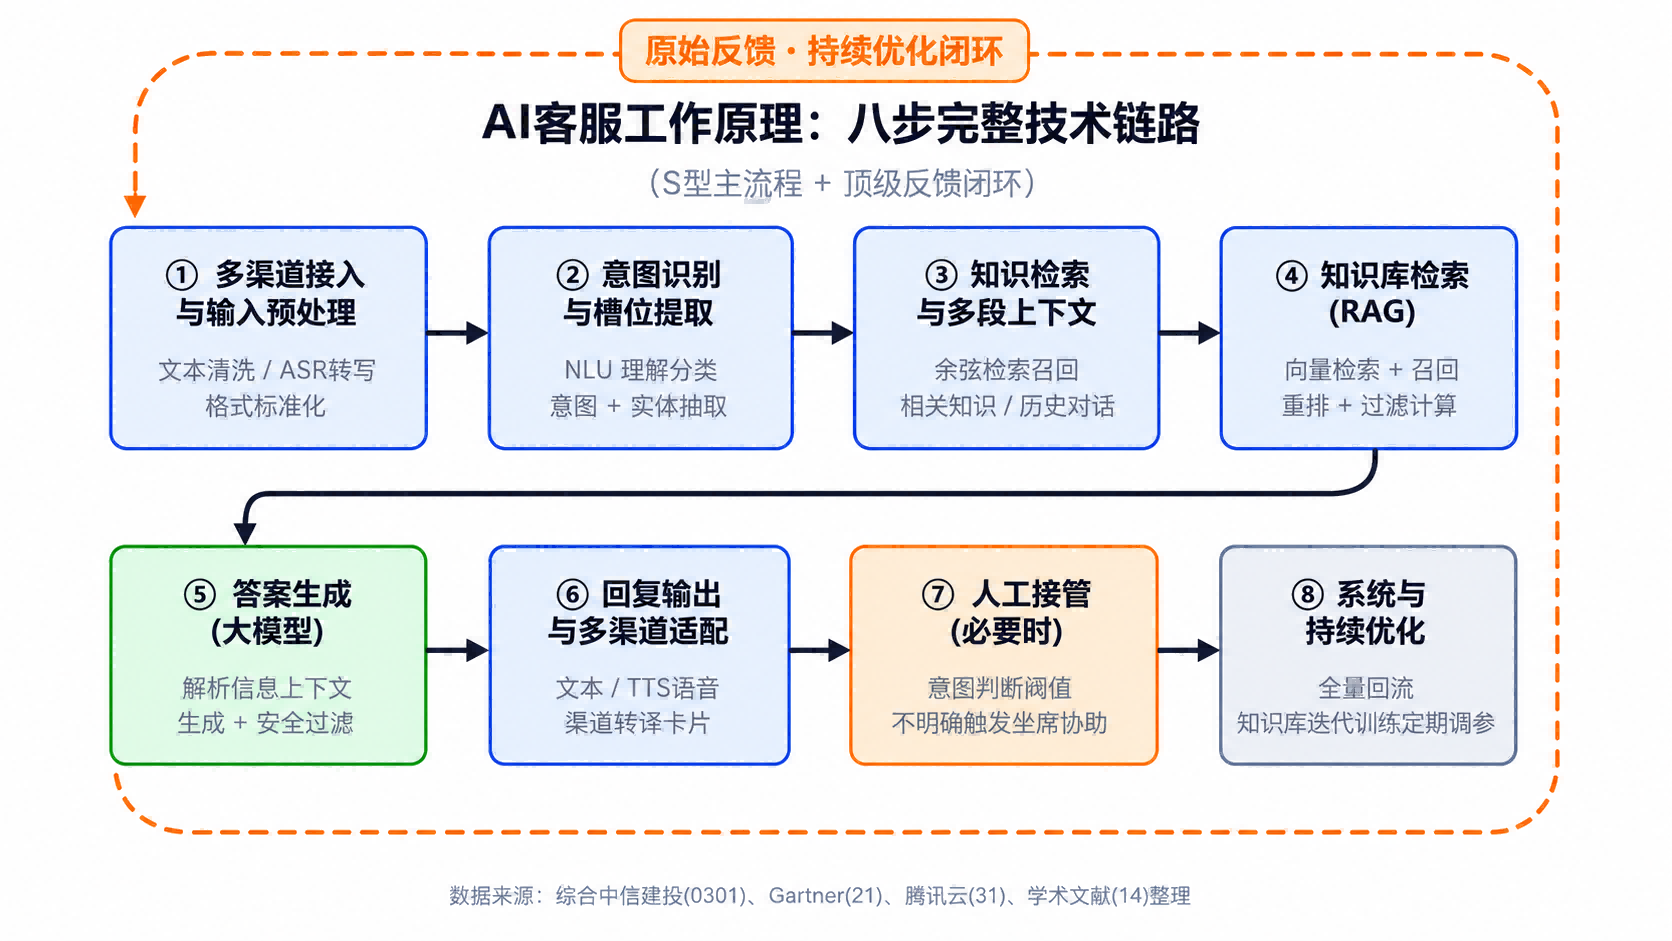
需要强调的是,这并非简单的”关键词匹配”。现代AI客服普遍采用大模型+检索增强生成(RAG)架构,使机器能够理解上下文、处理多轮对话,并在无法解决时平滑转交人工。下面逐一拆解关键环节。
二、多渠道接入与输入预处理
AI客服的第一步,是接收来自网站、App、微信公众号、企业微信、电话等多渠道的用户输入。不同渠道的输入形式各异——文本、语音、图片,需要统一预处理才能进入后续流程。
文本预处理
对于文本输入,系统通常需要进行清洗(去除无意义字符、纠正常见拼写错误)、分词、敏感词过滤等操作。这些步骤看似基础,但直接影响后续意图识别的准确性。
语音识别(ASR)
对于语音输入,系统首先通过自动语音识别(ASR)技术将语音转换为文本。据公开技术资料,当前领先的ASR系统在安静环境下的字错率通常可控制在5%以内[6]。Amazon的研究团队在多轮口语理解(SLU)领域的研究表明,结合对话历史的上下文信息,可以有效降低词错误率和语义错误率[6]。这意味着在多轮对话场景中,系统不仅能”听清”每个词,还能结合上下文”听懂”用户的真实意图。
三、意图识别与槽位抽取:让机器”听懂”客户
意图识别是AI客服的核心环节之一,决定后续检索和生成的方向。它的任务是判断客户这句话”想做什么”——是查询订单、咨询产品、投诉售后,还是闲聊。同时,槽位抽取负责提取关键实体信息,如订单号、产品名称、日期等。
从关键词匹配到语义理解
早期智能客服主要依赖关键词匹配和规则模板:系统预设知识库,用户提问后通过关键词命中预设答案。这套机制在问题标准、表达清晰时运作良好,但一旦语言偏离预设范围,或问题稍复杂,就容易出现”答非所问”。
大模型的出现改变了这一局面。基于Transformer架构的大语言模型具备自注意力机制,能够结合上下文理解语义,而非仅做字面匹配。康保斌等人在《制造业自动化》2024年的研究中指出,通用大模型虽语言流畅,但通常缺乏垂直领域知识,一般需要通过中间预训练、微调和RAG进行领域适配,才能在专业场景给出准确回答[4]。
三代技术演进
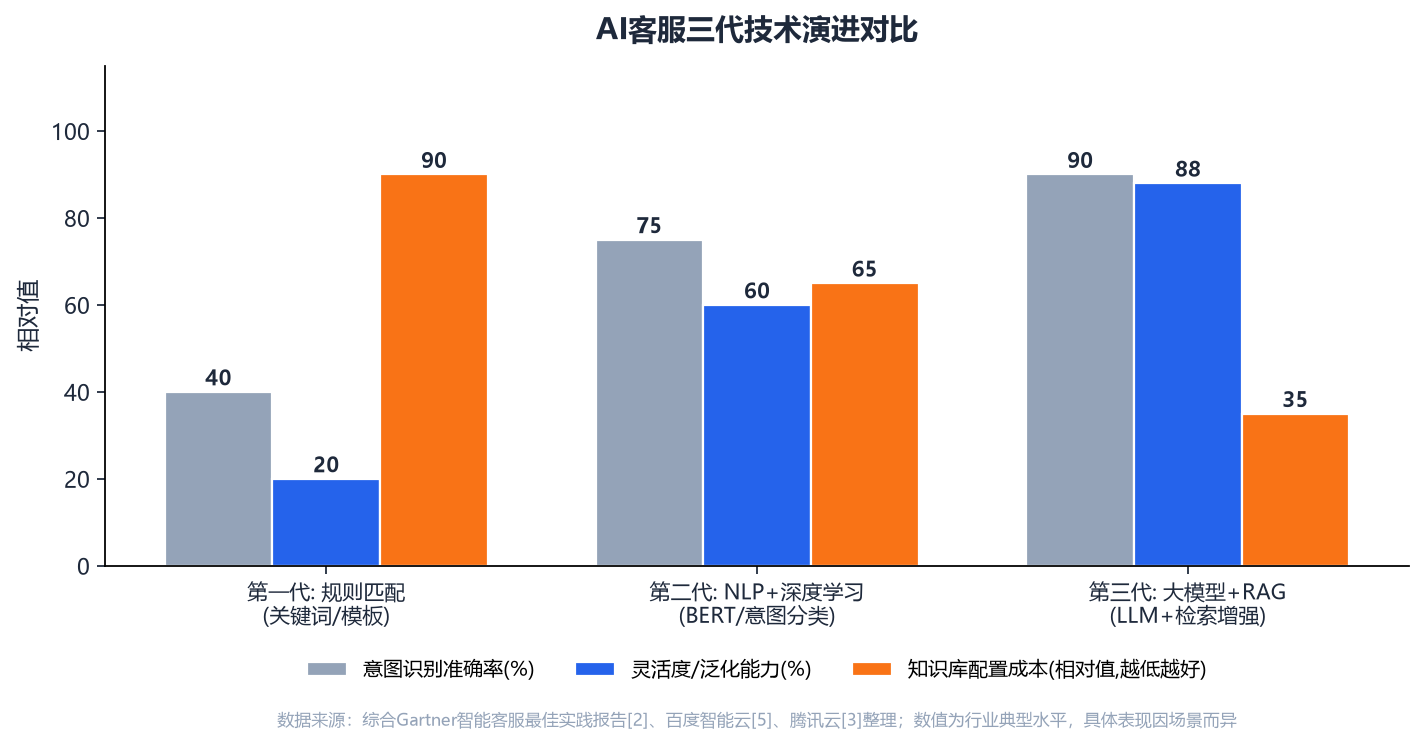
从技术演进角度看,AI客服经历了”规则匹配→NLP深度学习→大模型+RAG”三代发展。下图对比了三代技术在意图识别准确率、灵活度和配置成本上的差异:
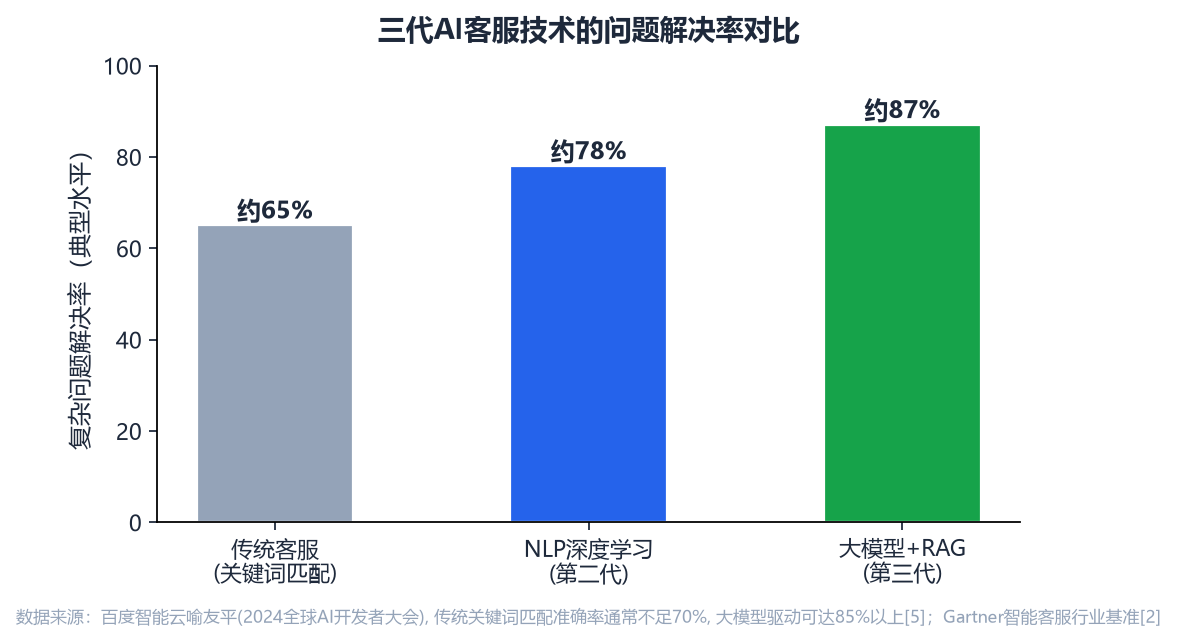
据百度智能云介绍,传统关键词匹配的准确率通常不足70%,而大模型驱动的方案在复杂问题上的解决率有望达到85%以上[5]。下图进一步对比了三代技术的问题解决率:
四、对话状态管理与多轮上下文
客户的问题往往不是一次就能说清楚的。”我要退换货”之后可能跟着”订单号是12345″,再跟着”原因是商品有破损”。AI客服需要记住前几轮的对话内容,才能正确理解后续输入。
对话状态管理(Dialogue State Tracking)负责维护当前对话的上下文信息,包括已提及的实体、用户偏好、当前任务进度等。Amazon的研究团队在端到端口语理解(SLU)领域的工作表明,利用多头注意力机制编码对话历史,可以显著降低词错误率和语义错误率,帮助系统在多轮对话中更准确地理解用户意图[6]。
在实际应用中,对话状态管理的能力直接影响多轮对话的连贯性。Gartner在2024年的调查中发现,多轮对话的上下文保持能力仍是当前技术的一个瓶颈,这也是为什么许多企业在落地时仍需要保留人工接管机制[2]。
五、知识库检索与答案生成:RAG如何减少”幻觉”
AI客服回答的内容从哪里来?答案是企业知识库。但大模型本身并不包含企业私有数据,直接让它”自由发挥”容易产生事实性错误的”幻觉”。检索增强生成(RAG)正是应对这一问题的关键架构。
RAG的工作机制
RAG的核心思路是”先检索、后生成”:当用户提问时,系统先通过向量检索从企业知识库中召回相关文档片段,再把检索到的内容作为上下文喂给大模型,由大模型基于这些事实材料生成回答。下图直观展示了RAG的完整工作流程:
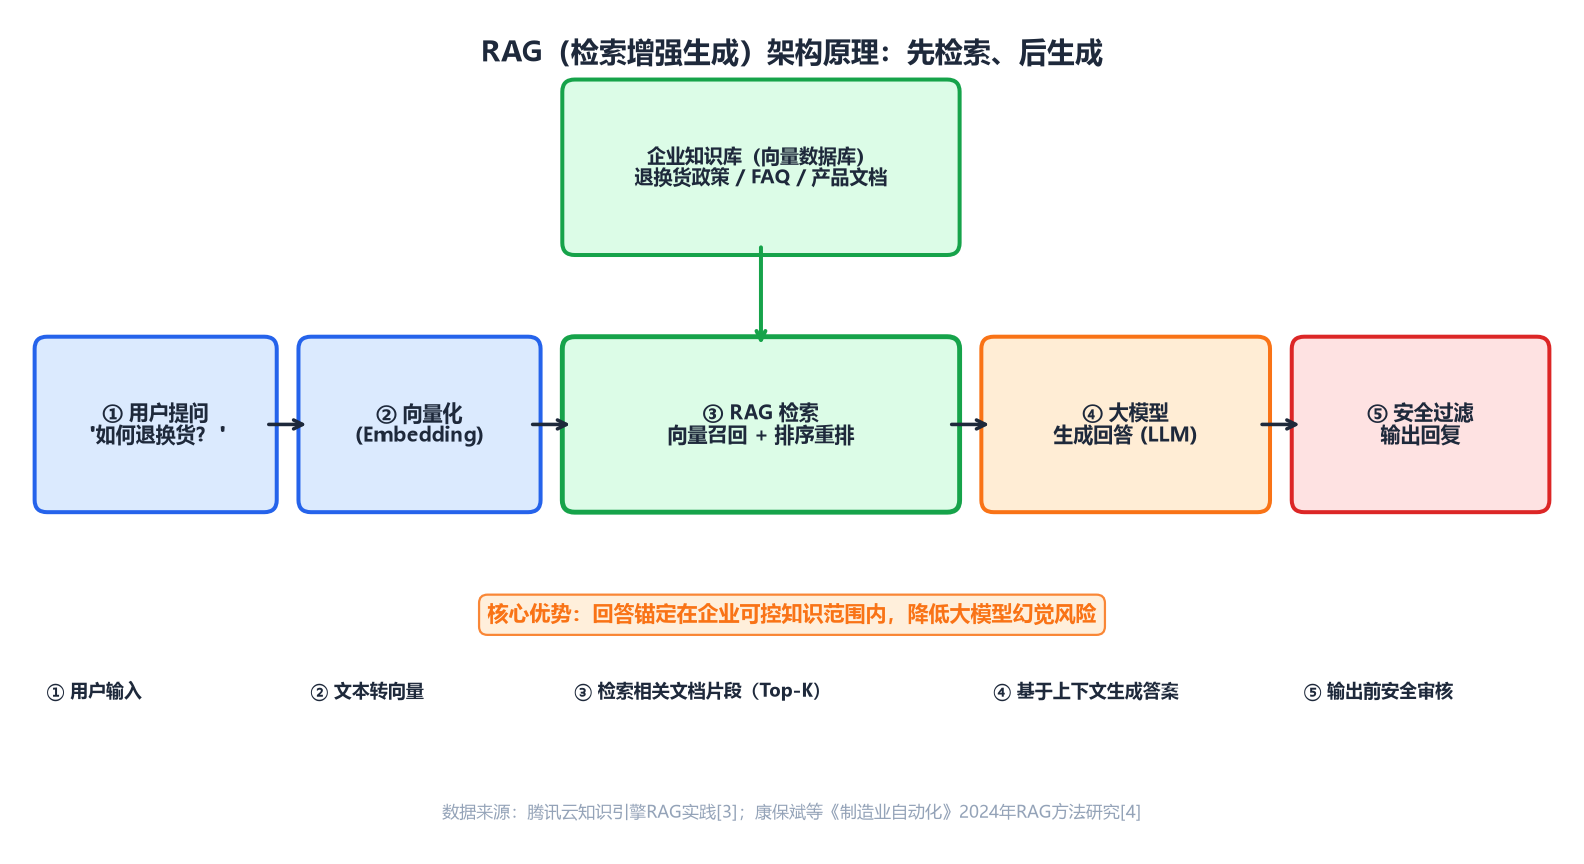
腾讯云在企点客服的实践中介绍,知识引擎以RAG架构为基础,整合OCR文档解析、向量检索和大语言模型,企业上传专属知识库后先生成大量问答,用户提问时先匹配文档片段再由模型推理,生成准确率相较通用大模型通常有所提升[3]。
这种”检索+生成”的方式,既保留了大模型自然流畅的表达能力,又把回答锚定在企业可控的知识范围内,有助于降低幻觉风险。
大模型降低配置成本
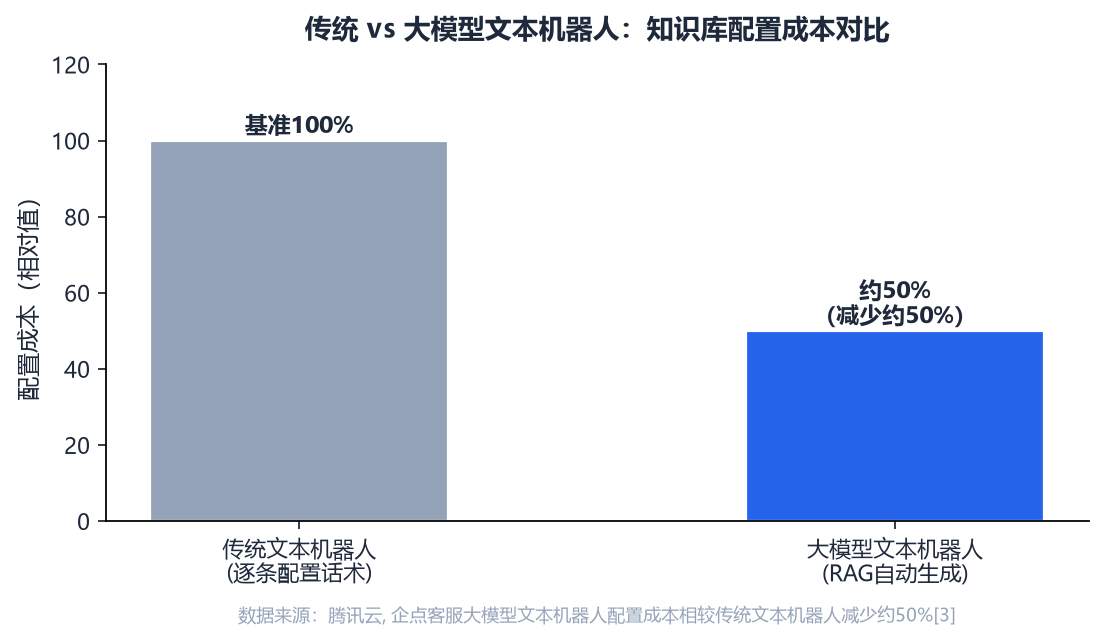
RAG架构的另一个价值是降低知识库的配置成本。传统文本机器人通常需要为每个问题手动配置话术和流程,维护负担较重。据腾讯云介绍,企点客服大模型文本机器人在处理账单查询、退换货等复杂任务时,配置成本相较传统文本机器人可减少约50%[3]:
六、回复输出与多渠道适配
大模型生成回答后,系统还需要将其适配到不同的输出渠道。对于文本渠道(网页聊天、微信),系统直接输出文本或富媒体卡片(如商品链接、订单状态卡片);对于语音渠道(电话客服),系统通过语音合成(TTS)技术将文本转换为自然语音。
此外,回复输出前通常还会经过一道安全过滤,检查内容是否涉及敏感信息、是否符合企业话术规范,确保输出内容的安全性和合规性。Gartner建议,企业可优先将大模型应用于内容生成、文本分析、通话摘要等内部活动,面向客户的场景则需保持谨慎[2]。
七、人工接管机制:人机协同而非完全替代
AI客服会出错吗?会。这也是为什么”人工接管”是技术链路中不可或缺的一环。业内通常采用”机器人处理标准化问题+人工承接复杂需求”的协作模式,而非追求完全替代人工。
什么时候转人工
常见的转人工规则通常包括:意图识别置信度低于设定阈值、连续多轮未命中答案、客户情绪激动或明确要求人工、涉及高风险业务(如金融交易、医疗决策)等。Gartner在2024年的调查中发现,83%的企业已有计划投资生成式AI或已经部署,其中94%的客服负责人正在探索员工侧虚拟助手或”副驾驶”,许多企业将其视为部署面向客户AI之前的实验性步骤[2]。
换言之,成熟的AI客服系统通常不是”替代人工”,而是构建”人在回路(human-in-the-loop)”的协作流程:机器处理高频标准问题,人工专注于复杂、情绪化和高价值场景[3]。
八、质检与持续优化:形成闭环
一条完整的AI客服技术链路,不应止步于”回复输出”。质检与持续优化是让系统不断进步的关键环节。
全量质检会对所有对话记录进行自动分析,识别知识库盲区、意图识别错误、客户满意度低的对话。这些反馈数据反过来用于知识库迭代(补充缺失问答、更新过时内容)和模型微调(优化意图识别准确率),形成”监测—分析—迭代”的闭环。据Gartner建议,企业可通过A/B测试对比不同对话策略的效果,利用日志分析定位知识库盲区,并定期进行模型微调,以保持准确率的稳定性[2]。
九、对企业选型的启示
理解AI客服工作原理,最终是为了做好选型与落地。建议企业关注三点:一是意图识别与问答准确率的真实评测数据(建议通过POC实测,而非仅看供应商宣传);二是知识库的搭建与维护成本(RAG架构通常可显著降低配置成本);三是人工接管规则的灵活度与转接顺畅性。如果你想进一步了解AI客服的功能清单、与人工客服的差异、系统搭建步骤、价格构成或选型方法,可参阅荷玥的相关文章(见文末内链)。
关于荷玥
荷玥聚焦企业智能客服与客户联络领域,提供基于大模型的AI客服系统、智能客服、AI语音、AI外呼、呼叫中心及营销自动化产品。荷玥AI客服系统采用意图识别+RAG知识库检索+大模型生成的技术架构,支持网站、微信、企微、App等多渠道统一接入,并提供灵活的人工接管与全量质检能力,帮助企业提升服务效率、降低运营成本。
了解荷玥AI客服系统的完整能力与适用场景,请访问:荷玥AI客服系统(产品页)。
常见问题(FAQ)
Q:AI客服如何识别问题?
A:AI客服通过NLP技术对用户输入进行语义分析,识别其意图(如查询、咨询、投诉)。大模型驱动的方案基于Transformer的自注意力机制理解上下文,而非仅做关键词字面匹配,因此对非标准表达通常也有较好的识别能力[1][4]。
Q:AI客服回答从哪里来?
A:回答通常来自企业知识库。系统采用RAG(检索增强生成)架构:先通过向量检索从知识库召回相关文档片段,再由大模型基于这些内容生成回答,从而把答案锚定在企业可控的知识范围内,有助于减少幻觉[3][4]。
Q:AI客服会出错吗?
A:会。大模型存在幻觉风险,因此成熟方案通常采用”人机协同”模式:机器人处理标准化问题,复杂或高风险场景转交人工。Gartner建议企业可先在内部活动(内容生成、通话摘要等)应用大模型,面向客户的场景需保持谨慎[2]。
Q:AI客服工作原理包含哪些核心环节?
A:完整的AI客服工作原理通常包含八个环节:多渠道接入与输入预处理、意图识别与槽位抽取、对话状态管理与多轮上下文、知识库检索(RAG)、答案生成(大模型)、回复输出与多渠道适配、人工接管、质检与持续优化[1][2][3]。
— — — — — — — — — — — — — — — — — — — — — — — — — — — — — —
想亲身体验荷玥AI客服的意图识别与RAG问答能力?
👉 预约荷玥AI客服演示 | 获取定制化智能客服落地方案
— — — — — — — — — — — — — — — — — — — — — — — — — — — — — —
数据来源与引用
本文所有关键数据均标注来源编号,对应如下权威报告与公开资料:
| 编号 | 来源机构 | 对应数据/观点 | 链接 |
| [1] | 中国信通院 | 《人工智能产业发展研究报告(2025年)》;新一代AI在意图理解、多模态交互、内容生成能力突出,加速向高附加值领域渗透 | caict.ac.cn |
| [2] | Gartner | Innovation Insight: Generative AI Chatbot to Improve CX and Agent Productivity (Uma Challa, 2024.04);83%企业计划投资GenAI, 94%客服负责人探索员工侧VA;多轮对话上下文保持仍为技术瓶颈 | gartner.com |
| [3] | 腾讯云 | 吴运声, 大模型知识引擎RAG架构实践;企点客服大模型文本机器人配置成本较传统减少约50% | new.qq.com/rain/a/20240517A05SEX00 |
| [4] | 学术文献 | 康保斌等《面向产业链上下游企业的基于LLM的垂直领域智能客服适配方法研究》,《制造业自动化》2024,46(6):7-12;RAG/微调方法研究 | qikan.cmes.org (DOI:10.3969/j.issn.1009-0134.2024.06.002) |
| [5] | 百度智能云 | 喻友平, 2024全球人工智能开发者大会演讲;传统客服关键词匹配准确率通常不足70%, 大模型驱动有望达85%以上 | cloud.baidu.com/article/4708024 |
| [6] | Amazon Science | Wei et al. “Attentive Contextual Carryover for Multi-Turn End-to-End SLU”, Alexa Speech; 结合对话历史的多头注意力机制可降低词/语义错误率;领先ASR系统安静环境字错率通常<5% | assets.amazon.science |
注:文中数据均为各机构公开报告或学术文献中的典型值/预测值,实际表现因企业场景、数据质量、模型配置等因素而异。